AIに資料を渡すほど、なぜ話がずれるのか
最初は「資料を多く渡したほうが賢くなる」と思いがちです。ところが実際は、資料を足すほど答えが安定しなくなる場面があります。
現場で起きやすいのは、次の3つです。今のルールがどれか分からない。古いメモをAIが拾う。作業ログと現行ルールが混ざる。すると、毎回の判断が遅くなります。
このとき、いきなり削除を始めると逆に危険です。必要な履歴まで消してしまう可能性があるからです。先にやるべきなのは、情報の種類を分けることです。
先にやるべきは削除ではなく、4分類
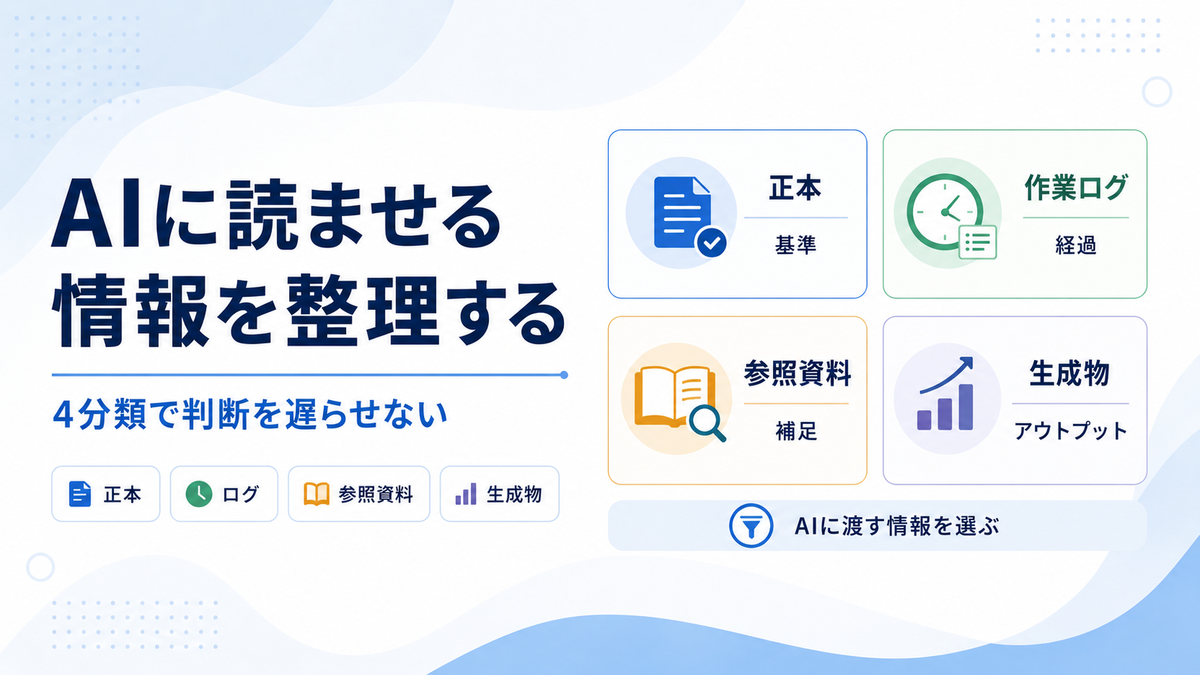
情報が散らかる問題は、ファイル数そのものより「役割が混ざっていること」で起きます。そこで最初に決めるのが、次の4分類です。
- 正本
- 作業ログ
- 参照資料
- 生成物
この4つを分けるだけで、AIに何を常時読ませるべきかが見えやすくなります。削除はその後で十分です。
正本・作業ログ・参照資料・生成物をどう分けるか
正本
今の判断に使うルールです。運用方針、承認条件、公開基準など、現在有効なものを置きます。AIに優先して読ませるのはここです。
作業ログ
試したこと、失敗、差し戻し理由、判断履歴です。価値は高いですが、常時参照にすると文脈が重くなります。原因調査や振り返りのときに取りに行く形にします。
参照資料
過去案や旧方針など、背景確認に必要な資料です。残してよいが、現行判断には直接使わない。ここが曖昧だと、古い前提が混ざりやすくなります。
生成物
AIやツールが出力した記事草稿、画像、ビルド結果などです。成果物として管理し、ルールと同じ棚に置かない。これを混ぜないだけでも、判断の起点がはっきりします。
海外の実践パターンを、日々の運用判断に置き換える
海外の実践知で共通しているのは、難しい道具を増やすことより、文脈をどう管理するかを先に決める姿勢です。
まず、指示には階層を持たせます。優先順位が曖昧なまま同列で増やすと、矛盾が起きやすくなります。
次に、文脈は「全部入れる」より「意図的に絞る」。常時参照と必要時参照を分けると、古い情報が割り込みにくくなります。
さらに、高リスク操作には人の承認を残します。公開、外部送信、削除のような操作は、スピードより監査可能性を優先したほうが後で助かります。
要するに、運用の中心はこうです。何を読ませるかだけでなく、何を常時は読ませないかを決める。
実際の運用で先に直したのは「量」ではなく「参照ルール」だった
実際の運用でも、最初に効いたのは大量削除ではありませんでした。公開状態を一覧で確定する。次候補を公開後に同期する。公開後成果物をそろえる。この順で「判断に使う情報」を絞ったことで、どこを見て決めるかが揃ってきました。
ここで大事なのは、特定のフォルダ構成を真似することではありません。自分の環境でも、4分類を先に作り、参照順序を固定することです。形は違っても、考え方はそのまま使えます。
初心者が最初の1週間でやること
1週間だけでいいので、次の順番で試してみてください。
- 手元の資料を4分類する(正本・作業ログ・参照資料・生成物)。
- AIに常時渡すのは正本だけにする。
- 作業ログと参照資料は、必要になったときだけ参照する。
- 生成物を新しいルールとして扱わない。
- 1週間分の出力ズレと差し戻し理由を記録する。
この記録があると、次に直すべき場所が感覚ではなく理由で決められます。
まとめ: 情報量より、分類と参照順序が運用を決める
AI運用で情報が散らかる原因は、資料が多いこと自体より、役割が混ざっていることにあります。
削除を急ぐより先に、正本・作業ログ・参照資料・生成物を分ける。次に、AIへ常時渡す範囲と必要時参照の範囲を決める。この順番で進めると、古い文脈の混入を抑えやすくなります。
まずは1週間だけ、小さく回してみてください。出力ズレが起きた理由を追えるようになるだけでも、次に直す場所を判断しやすくなります。
分類ができたら、次は公開前の判定フローをそろえる段階です。実運用での確認手順は公開前に決めるべき確認フローで具体化しています。